MODULE 01 // ARCHITECTURE & HIGHFLEX HARNESS
SERIAL: TI-DS-R1-671B
幻方量化算力基石 · MLA 稀疏潜在注意力
依托幻方量化深厚的大规模高性能集群调度经验,DeepSeek 深度求索重构了通用大模型的推理基础设施。通过多头潜在注意力(MLA)机制将长上下文的 KV 显存占用大幅压缩,在拉丝钛金属机箱般严密的工业稳定性下,输出毫秒级的首字时延。
# DeepSeek MLA 潜在注意力压缩算子实现
k_compressed = latent_down_proj(kv_hidden_states)
v_compressed = latent_down_proj(kv_hidden_states)
# 显存开销仅为传统注意力机制的 16.7%,支持超高并发并发会话吞吐
MODULE 02 // MULTI-SCENARIO HARNESS BENCH
GRADE: TITANIUM PRECISION
高精度形式化验证与代码工程 Diff 自愈
面对复杂的代码重构与极端边界条件推导,模型具备自主反思、假设推翻与回溯验算能力。在纯强化学习演进中展现出惊人的自愈力与完备的上下文捕捉能力。
MODULE 03 // HARNESS SCREW ARRAY INTERFACE
STATUS: HARNESS RIG MOUNTED
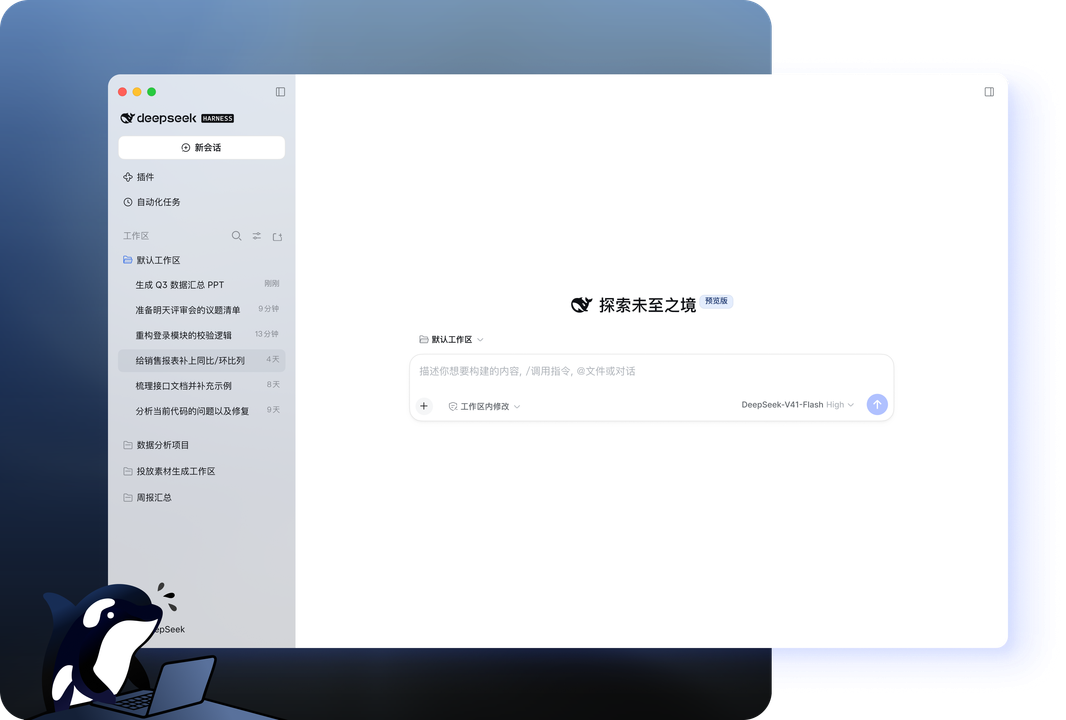
DeepSeek Harness 钛螺丝阵列评测桌面端
面向企业开发者与算法实验室,DeepSeek Harness 提供了标准化本地推理测试套件。一键度量端侧硬件吞吐、长文本首字时延以及复杂形式化证明的收敛效率。